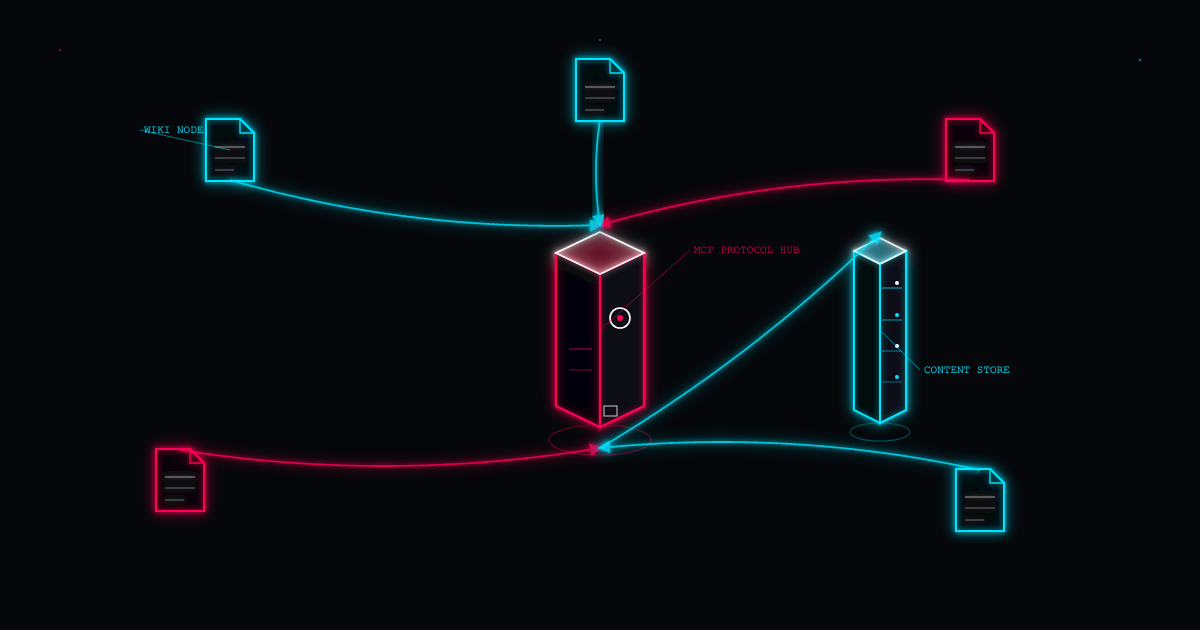
'Your Personal Context, Native to Your AI' – so der Pitch von GraphMySelf, einem Personal Knowledge Graph Tool, das Resume, LinkedIn, GitHub, Notion in einen MCP-Server verwandelt. Cursor und Claude bekommen Kontext via Model Context Protocol, statt auf generisches Training-Data zu raten. EpisTwin (arXiv 2603.06290, März 2026) geht tiefer: Ein neuro-symbolisches Framework, das cross-app Multimodal-Daten in Semantic Triples hebt. Graph RAG + Online Deep Visual Refinement, evaluated auf PersonalQA-71-100 Benchmark. Das gelöste Problem: Fragmentierte User-Daten in isolierten Silos, unstrukturierte Vector-Similarity erfasst keine temporalen Dependencies.
GraphMySelf: Identity Graph mit MCP-Server
GraphMySelf adressiert Job-Seeker, Researchers, Consultants, Creators: User uploaden Resume, linken LinkedIn, connecten GitHub/Notion. Die async Pipeline parsed, chunkt, preserves semantic Relationships. Jeder Chunk wird Node mit Vector-Embeddings.
Das Interactive Graph-UI zeigt die Personal Identity visuell: Skills connected zu Projects, Projects zu Companies, Companies zu Timeframes. User können drag, edit, enrich – direktes Editing im Node-based Graph.
Der MCP-Server geht instant live: Add zu Cursor, Claude Desktop, Gemini → AI bekommt accurate, real-time Personal Context auf every Query. Beispiel: "Write a cover letter for this Software-Engineer-Position" → Claude liest GraphMySelf-Vault → kennt actual Work-History, Skills, Projects → tailored Cover Letter statt generic Template.
Die Developer-Native-Features: API-first Architecture, Plugin-System für custom Data-Sources (Trello, Asana, Slack), Export/Delete alles via Dashboard.
EpisTwin: Neuro-Symbolic Personal Knowledge Graph
EpisTwin (Servedio et al., Polytechnic of Bari) tackelt das "Personal AI is hindered by data fragmentation across isolated silos"-Problem. Während RAG relies on unstructured Vector Similarity, baut EpisTwin ein verifiable, user-centric Personal Knowledge Graph.
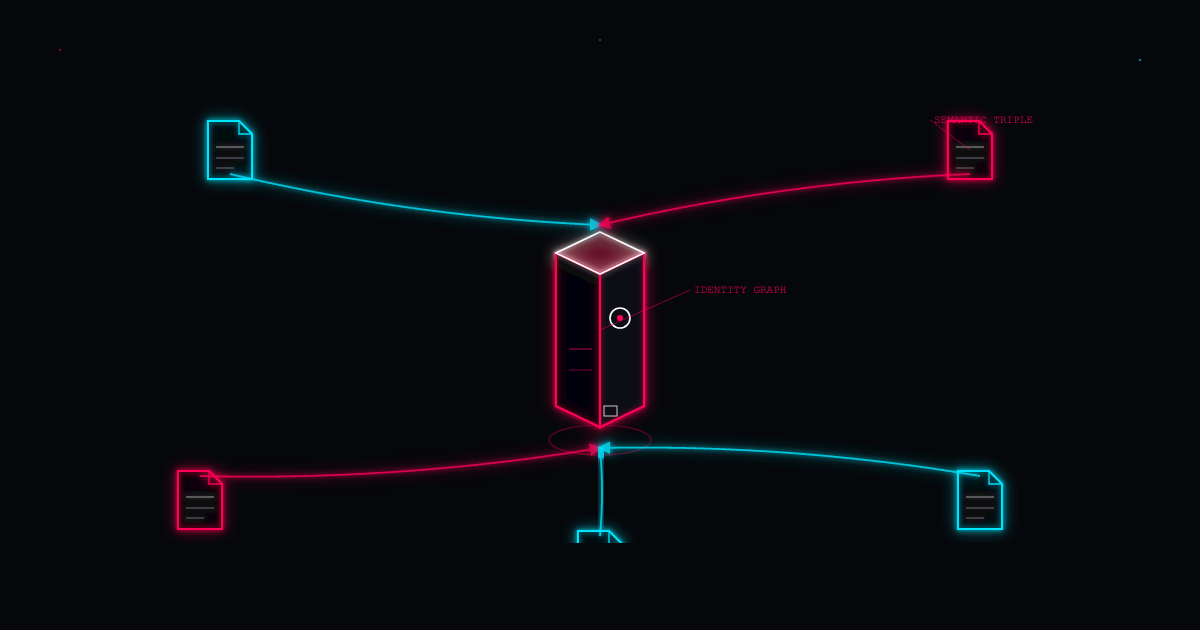
Multimodal Language Models liften heterogeneous, cross-application Data in Semantic Triples (Subject-Predicate-Object). Bei Inference kombiniert EpisTwin Graph Retrieval-Augmented Generation mit Online Deep Visual Refinement: Symbolic Entities werden re-grounded in their raw Visual Context.
Der PersonalQA-71-100-Benchmark simuliert realistic User's Digital Footprint: 71-100 Questions über Emails, Calendars, Photos, Documents, scattered across Apps. EpisTwin demonstriert robust Results across State-of-the-Art Judge Models.
Graph RAG vs. Flat Vector RAG
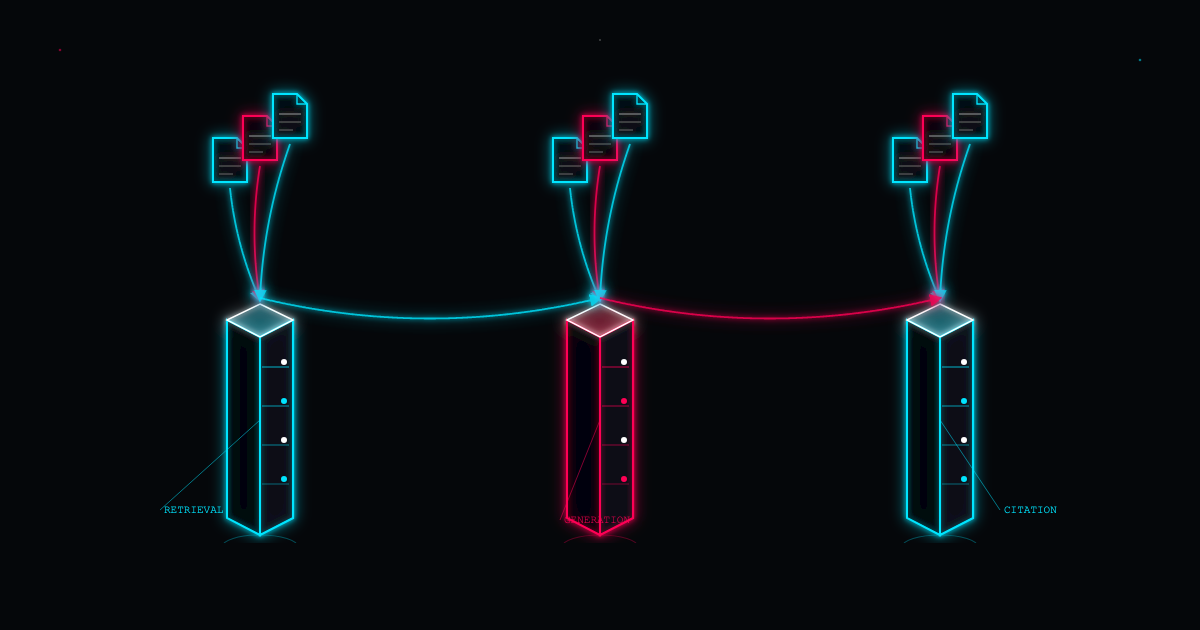
Flat RAG: User-Query → Embedding → Vector-Search → Top-K Chunks → LLM generates Answer. Funktioniert für "What did I write about X?", scheitert bei "What was the timeline of Project Y and who was involved when?"
Graph RAG: User-Query → Graph-Traversal → finds Entity-Nodes (Project Y) → traverses Relationships (involved-Persons, Timeframes, Milestones) → synthesizes Answer mit temporal + relational Context.
EpisTwin's Visual Refinement: Ein Project-Node linkt zu Meeting-Screenshot. LLM liest Screenshot (OCR), extractiert Context (Whiteboard-Sketch zeigt Architecture), kombiniert mit Graph-Knowledge → vollständiger Answer.
Use Cases: Consultants, Freelancer, Recruiter
Consultants/Freelancer:
Portfolio als queryable Graph: "Show clients I worked with in FinTech 2023-2025 with successful outcomes" → Graph traversiert Company-Nodes (Industry=FinTech, Timeframe=2023-2025) → filters by Outcome-Status → returns List mit Citations (Proposals, Invoices, Testimonials).
Recruiter:
CV-Datenbank wird semantisch durchsuchbar: "Find Backend-Engineers with Rust-Experience and Cloud-Native-Projects" → Graph matcht Skill-Nodes (Rust) + Project-Type-Nodes (Cloud-Native) → ranked Results by Recency + Relevance.
Researchers:
Research-Papers + Citations + Ideas als Graph: "What concepts connect Paper A and Paper B?" → Graph findet shared Citation-Nodes, co-occurring Concept-Nodes → visualizes Connection-Path.
Privacy und Ownership
GraphMySelf: Data encrypted at Rest + in Transit, Export/Delete alles anytime, kein Training on User-Data.
EpisTwin: User-centric Graph bleibt lokal (kann deployed werden on-premise), keine Cloud-Sync required.
Das adressiert das größte PKM-Risiko: Tools die closed-source sind, User-Data für Training nutzen, keine Export-Option bieten. Graph-based PKM mit MCP-Standard garantiert Portability: Wechsel von GraphMySelf zu anderem MCP-fähigen Tool ohne Data-Loss.
Personal Knowledge Graphs machen fragmentierte User-Daten AI-native: GraphMySelf (Resume/LinkedIn/GitHub → MCP-Server) gibt AI accurate Personal Context. EpisTwin (neuro-symbolic Framework) löst temporal + relational Queries via Graph RAG + Visual Refinement. Use Cases: Consultants (queryable Portfolio), Recruiter (semantic CV-Search), Researchers (linked Papers). Privacy: Encrypted, exportable, lokal-deployable. Das Ende von 'AI rät aus Training-Data' – der Anfang von 'AI kennt mich wirklich'.