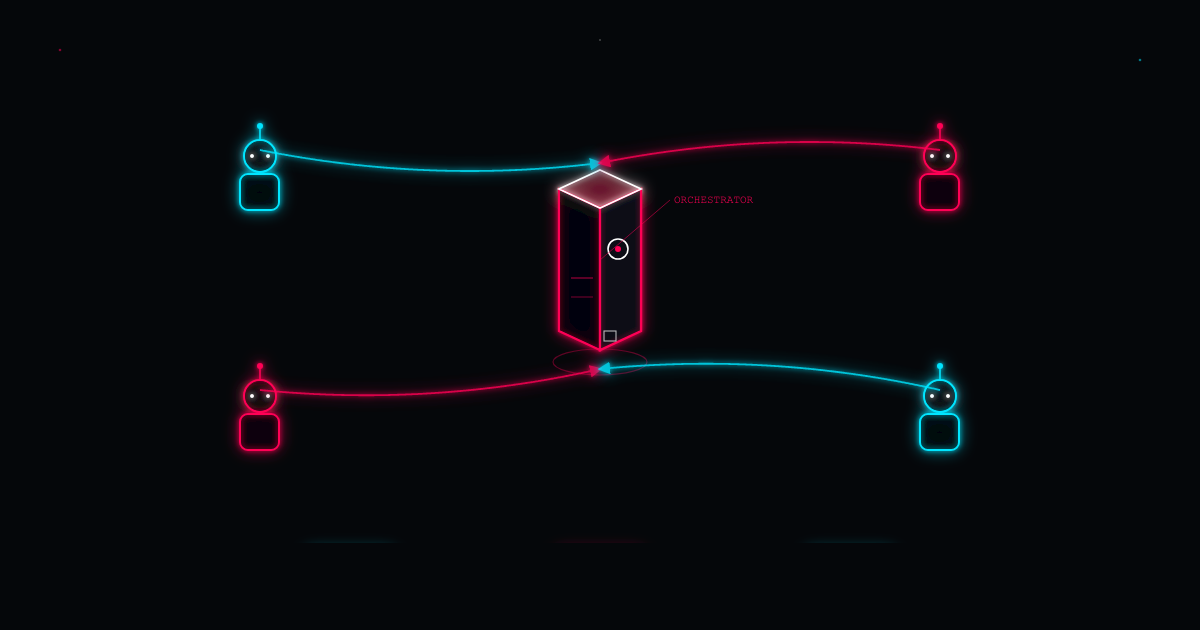
Enterprise Knowledge Management erreicht 2026 Production-Reife: IBM, Microsoft und Progress liefern vollständig automatisierte RAG-Pipelines, die in Tagen statt Monaten deployen. IBM watsonx Orchestrate mit ContentIQ-Agent verspricht Go-Live in 2 Tagen, Microsoft Foundry IQ bringt Permission-aware Retrieval über SharePoint/OneLake/Azure Blob, Progress Agentic RAG unterstützt 40+ LLMs mit Model-Switch ohne Re-Index. Alle drei setzen auf dieselben Prinzipien: Multi-Source-Retrieval, Citation-backed Answers, Role-based Access Control. Der Unterschied zu klassischem RAG: Agentic Retrieval zerlegt Queries in Subqueries, sucht parallel, rerankt, synthesiert – statt einem Embedding-Lookup.
IBM watsonx Orchestrate: No-Code RAG in 2 Tagen
IBM watsonx Orchestrate nutzt den vorgebauten Agent ContentIQ von symplistic.ai (verfügbar im Agent Catalog). Der Pitch: "Turn your SOPs, manuals and websites into trusted answers with citations. Deploy in days, without a data science team."
Die Pipeline automatisiert Chunking, Vectorization, Metadata-Extraction – No-Code, zero Configuration. User connecten SharePoint, OneDrive, Box, Google Drive, Websites, behind-the-firewall Content. Der Agent crawlt, bereinigt, ingestiert. Der Clou: Role-based Access Control inherited von Source-Systemen – Antworten respektieren existing Permissions.
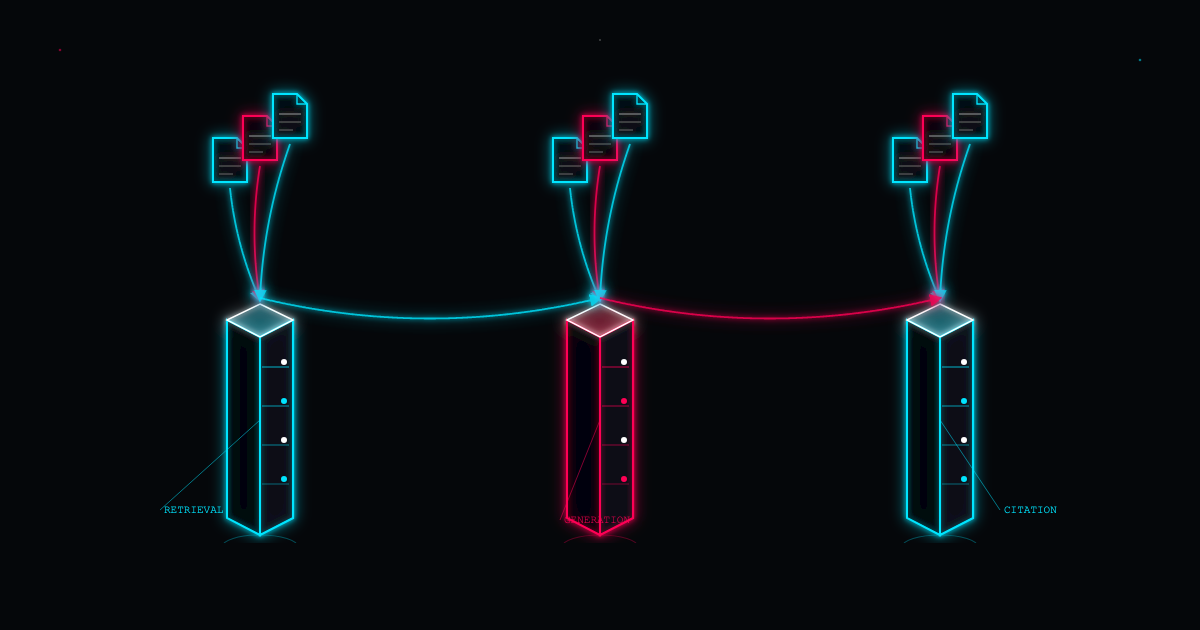
Jede Antwort kommt mit Citation: Link zurück zum Source-Doc, sodass User verifizieren können. Antworten sind strictly grounded in User-Content, keine blended public web data. Das adressiert das Hallucination-Problem: "No answer without source" ist Policy.
Microsoft Foundry IQ: Permission-Aware Agentic Retrieval
Microsoft Foundry IQ sitzt auf Azure AI Search und orchestriert Retrieval über indexed (SharePoint, OneLake, Azure Blob) und remote Knowledge Sources. Agentic Retrieval ist das Differentiator-Feature: Die Pipeline dekomponiert komplexe Fragen in Subqueries, executed parallel, semantically reranks Results, returns unified Responses.
Permission Enforcement passiert at Query Time: User fragt → Foundry IQ prüft Entra Identity → retrieves nur authorized Content. Zwei User fragen dasselbe, bekommen unterschiedliche Antworten (je nach Access Rights). Das ist kritisch für Enterprises: Ein Knowledge Agent, der sensitive Docs leaked, ist ein Data Breach mit Chat-Interface.
Foundry IQ synchronisiert Access Control Lists (ACLs) von Source-Systemen und honored Microsoft Purview Sensitivity Labels. Jede Query läuft unter Caller's Entra ID – end-to-end Permission Enforcement.
Progress Agentic RAG: 40+ LLMs, Model-Agnostic
Progress Agentic RAG löst das "Vendor-Lock-in"-Problem: 40+ LLMs supported (OpenAI, Claude, Gemini, Llama, Mistral), Model-Switch via Single Config Change. Die Retrieval-Pipeline, Knowledge Base und Evaluation-Setup bleiben intact – nur das LLM wechselt.
Das adressiert Enterprise-Reality: Heute Claude wegen Accuracy, morgen Gemini wegen Cost, übermorgen Llama wegen Data Residency. Progress nennt das "LLM-agnostic": Die Knowledge Layer ist permanent, das Model ephemeral.
REMi Evaluation Metrics messen Groundedness (wie eng die generated Answer an retrieved Context tied ist). Sinkt Groundedness, alerted das System → User adjustieren Retrieval-Strategy oder updaten Knowledge Base.
Agentic Retrieval vs. Classic RAG
Classic RAG: User Query → Embedding → Vector Search → Top-K Chunks → LLM generates Answer. Single-Shot, keine Reasoning.
Agentic RAG: User Query → Agent decomposes → parallel Subqueries → retrieves from multiple Sources → reranks by Relevance + Freshness → validates for Contradictions → synthesizes complete Answer. Multi-Step, reasoning-fähig.
Beispiel: "What's the escalation path for a failed settlement?" Classic RAG findet vielleicht eine SOP. Agentic RAG findet SOP (Policy), Confluence-Page (Workflow), closed ServiceNow-Ticket (real Case), reconciles Contradictions, synthesized vollständige Antwort mit Citations zu allen drei Sources.
Enterprise-Adoption und ROI
IDC schätzt 5M+ USD Lost per 1.000 Workers/Jahr durch Information Recreation: Mitarbeiter suchen, finden nicht, bauen neu auf. Agentic RAG eliminiert das: Direct Answer statt List of Links.
Die Deployment-Velocity ist der Business-Case: IBM 2 Tage, Microsoft Wochen (je nach Source Complexity), Progress ähnlich. Verglichen mit klassischen RAG-Projekten (6+ Monate Build, 3 Monate Tuning) ist das disruptiv.
Für KMUs: Confluence, SharePoint, ServiceNow – alles in einer durchsuchbaren, citation-backed Antwort. Permission-Aware = keine Compliance-Risiken. Zero Training Data Leakage = GDPR-konform out-of-the-box.
Agentic RAG 2026 macht Enterprise Knowledge Management produktionsreif: IBM watsonx (2-Tage-Deploy), Microsoft Foundry IQ (Permission-Aware Retrieval), Progress (40+ LLMs, Model-Switch). Statt manueller Wiki-Pflege orchestrieren Agents Wissen über alle Systeme hinweg. Multi-Source-Retrieval, Citation-backed Answers, RBAC: Der Stack ist Enterprise-grade. Für KMUs bedeutet das: Confluence/SharePoint/ServiceNow → eine Antwort mit Quelle, Zero Manual Maintenance, GDPR-konform. Knowledge Debt wird endlich adressierbar.