Enterprise Knowledge Management steht vor einem Dilemma: Organisationen haben jahrzehntelang in Dokumenten-Repositories, Wikis, Intranets und Knowledge-Bases investiert. Diese Systeme funktionieren, aber ihre Nutzung ist mühsam – manuelle Suche, inkonsistente Strukturierung, fragmentierte Information. Progress adressiert dies mit Agentic RAG: Einer Plattform, die bestehende Knowledge-Systeme durch intelligente AI-Agenten zugänglich macht, ohne kompletten System-Rebuild.
Das Enterprise-Knowledge-Problem
Typische Großunternehmen betreiben Dutzende Informationssysteme: SharePoint für Dokumentenmanagement, Confluence für Team-Wikis, ServiceNow für IT-Knowledge, proprietäre Systeme für Product-Documentation, regulatorische Datenbanken, E-Mail-Archive. Information ist fragmentiert, Auffindbarkeit schlecht.
Mitarbeiter verbringen durchschnittlich 20 Prozent ihrer Arbeitszeit mit Informationssuche. Ein Customer-Support-Agent muss vier verschiedene Systeme checken, um eine Produktfrage zu beantworten. Ein Compliance-Officer durchforstet hunderte Dokumente für regulatorische Updates. Diese Ineffizienz kostet Milliarden.
Frühere Lösungsansätze – Enterprise-Search-Engines, Knowledge-Management-Plattformen – scheiterten an Komplexität und mangelnder Adoption. Die Systeme erforderten aufwändige Konfiguration, manuelle Taxonomien und lieferten oft irrelevante Suchergebnisse.
Retrieval-Augmented Generation als Gamechanger
RAG kombiniert Information Retrieval mit Generativer AI. Statt Dokumente zu durchsuchen und dem User zu präsentieren, findet das System relevante Informationen und synthesiert daraus direkte Antworten. Der User fragt "Was ist unsere Rückgabepolicy für defekte Produkte?" und erhält eine präzise Antwort, nicht eine Liste von Dokumenten.
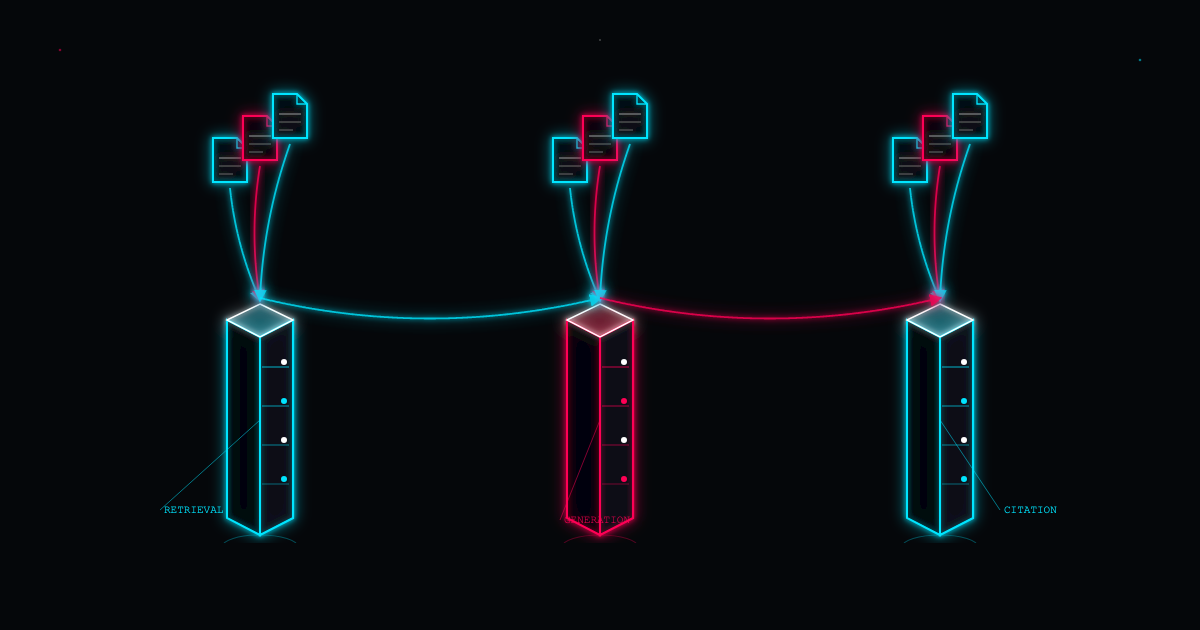
Die technische Implementation: Dokumente werden in semantische Chunks zerlegt und als Embeddings in Vector Databases gespeichert. User-Queries werden ebenfalls embedded und ähnliche Chunks via Similarity-Search identifiziert. Diese relevanten Chunks werden einem Large Language Model als Kontext übergeben, das eine natürlichsprachliche Antwort generiert.
Der Vorteil: Das System versteht semantische Beziehungen, nicht nur Keywords. Synonyme, verwandte Konzepte, implizite Verbindungen – alles wird erfasst. Die Antworten sind synthetisiert, nicht nur copy-paste aus Dokumenten.
Der "Agentic" Unterschied
Progress erweitert klassisches RAG durch autonome Agenten. Statt simpel Query → Retrieval → Answer, orchestrieren Agenten komplexere Workflows: Multi-Step-Reasoning, Cross-System-Queries, kontextuelle Nachfragen, proaktive Informationsbereitstellung.
Ein konkretes Beispiel: Ein Mitarbeiter fragt "Wie ist der Genehmigungsprozess für Marketingbudget über 50.000 Euro?". Der Agent identifiziert, dass mehrere Informationsquellen relevant sind: Policy-Dokumente für den formalen Prozess, historische Approval-Daten für Durchlaufzeiten, Organigramm für Approval-Hierarchie. Der Agent queried alle Systeme, korreliert Informationen und liefert eine umfassende, strukturierte Antwort.
Proaktivität ist ein weiteres Feature. Der Agent erkennt, wenn neue Policies veröffentlicht werden, die für spezifische User-Gruppen relevant sind, und sendet proaktive Notifications. Oder er identifiziert widersprüchliche Informationen über Systeme hinweg und flagged sie für Bereinigung.
Integration ohne Rebuild
Die Killer-Capability von Progress ist die nahtlose Integration mit existierenden Systemen. Standard-Konnektoren für SharePoint, Confluence, Salesforce, ServiceNow, Box, Dropbox und dutzende weitere ermöglichen schnelles Onboarding.
Die Systeme bleiben unverändert. Progress liest Inhalte via APIs, transformiert sie für RAG, aber die Source-of-Truth bleibt in den originalen Systemen. Updates werden automatisch synchronisiert. Dies vermeidet die Migration-Albträume, die frühere Konsolidierungsprojekte plagten.
Die Implementierungszeit ist radikal kürzer. Wo traditionelle Enterprise-Search-Projekte Monate oder Jahre dauerten, sind Progress-Deployments in Wochen produktiv. Die initiale Konfiguration umfasst System-Connections, Access-Control-Mapping und optional Fine-Tuning der Retrieval-Strategie.
Security, Access Control und Compliance
Enterprise-Knowledge ist sensitiv und zugriffsgeschützt. Progress implementiert granulare Permission-Preservation: User sehen in AI-Antworten nur Informationen, auf die sie auch in den Quellsystemen Zugriff haben.
Die technische Umsetzung ist komplex. Bei jedem Retrieval prüft das System die User-Identity gegen Quellsystem-Permissions. Nur accessible Chunks werden an das LLM übergeben. Dies verhindert Permission-Leakage über AI-Antworten.
Audit-Trails dokumentieren jede Query und welche Quellen für Antworten genutzt wurden. Dies unterstützt Compliance-Anforderungen und ermöglicht Troubleshooting wenn Antworten inkorrekt sind.
Daten-Residency und Privacy werden adressiert. Für EU-Kunden können Processing und Storage in EU-Datacenters erfolgen. On-Premises-Deployment ist für hochsensitive Umgebungen verfügbar. Die LLMs können Customer-Managed sein, reduziert Abhängigkeit von Third-Party-AI-Providern.
Use Cases in der Praxis
Customer Support profitiert dramatisch. Agents nutzen Agentic RAG für instant Zugriff auf Product-Knowledge, Troubleshooting-Guides, Policy-Dokumente. Die Average-Handling-Time sinkt, First-Contact-Resolution steigt.
Employee Onboarding beschleunigt sich. Neue Mitarbeiter stellen Fragen in natürlicher Sprache – "Wie beantrage ich Urlaub?" oder "Was ist die Policy zu Home Office?" – und erhalten sofortige, präzise Antworten statt stundenlangem Manual-Durchforsten.
Compliance und Legal nutzen RAG für Research. Die Frage "Welche GDPR-Anforderungen betreffen unser neues Produkt-Feature?" triggert Queries über Regulierungs-Datenbanken, interne Policies und Best Practices.
Product Development greift auf Technical Documentation zu. Engineers finden API-Spezifikationen, Architektur-Entscheidungen, Legacy-Code-Erklärungen – oft dokumentiert vor Jahren von längst abgewanderten Kollegen.
Grenzen und Herausforderungen
Die Qualität hängt von Quell-Daten ab. Schlecht dokumentiertes, veraltetes oder widersprüchliches Knowledge führt zu suboptimalen Antworten. RAG ist kein Ersatz für Knowledge-Curation, macht diese jedoch transparenter – schlechte Dokumentation wird durch schlechte AI-Antworten sichtbar.
Halluzinationen bleiben eine Herausforderung. LLMs können auch mit RAG falsche Informationen generieren. Progress implementiert Konfidenz-Scores und Source-Citations, aber User müssen kritisch bleiben.
Die Kosten skalieren mit Datenvolumen und Query-Frequenz. Vector-Database-Storage, Embedding-Generierung und LLM-Inferenz pro Query addieren sich. Für sehr große Enterprises mit Millionen Dokumenten und tausenden täglichen Queries ist sorgfältiges Capacity-Planning nötig.
Die Zukunft von Enterprise Knowledge
Agentic RAG repräsentiert einen Paradigmenwechsel: Von "Search and Navigate" zu "Ask and Receive". Die Zukunft ist konversational – Mitarbeiter interagieren mit Enterprise-Knowledge wie mit einem hochinformierten Kollegen.
Die Integration wird tiefer. Agenten werden nicht nur Fragen beantworten, sondern Actions ausführen: Tickets erstellen, Approvals initiieren, Dokumente updaten. Die Grenze zwischen Information-Access und Workflow-Automation verschwimmt.
Progress Agentic RAG ist ein Beispiel eines breiteren Trends: AI macht Legacy-Systeme nutzbar ohne Replacement. Dies ist pragmatisch und wirtschaftlich – der ROI kommt schneller, das Risiko ist niedriger als bei Big-Bang-Modernisierungen.