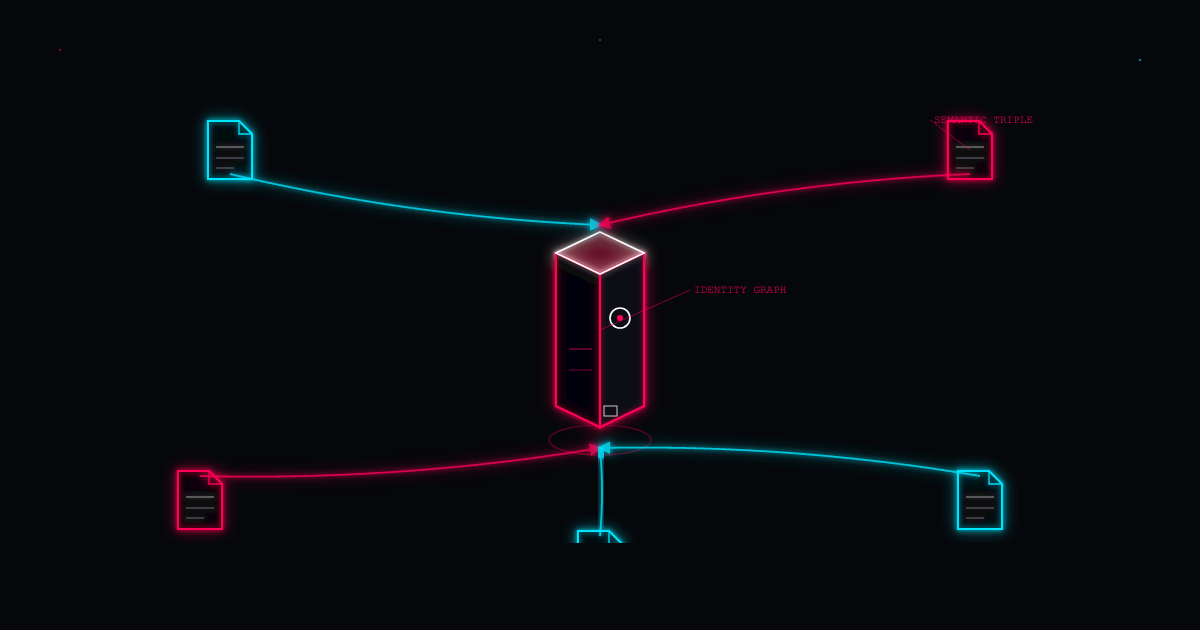
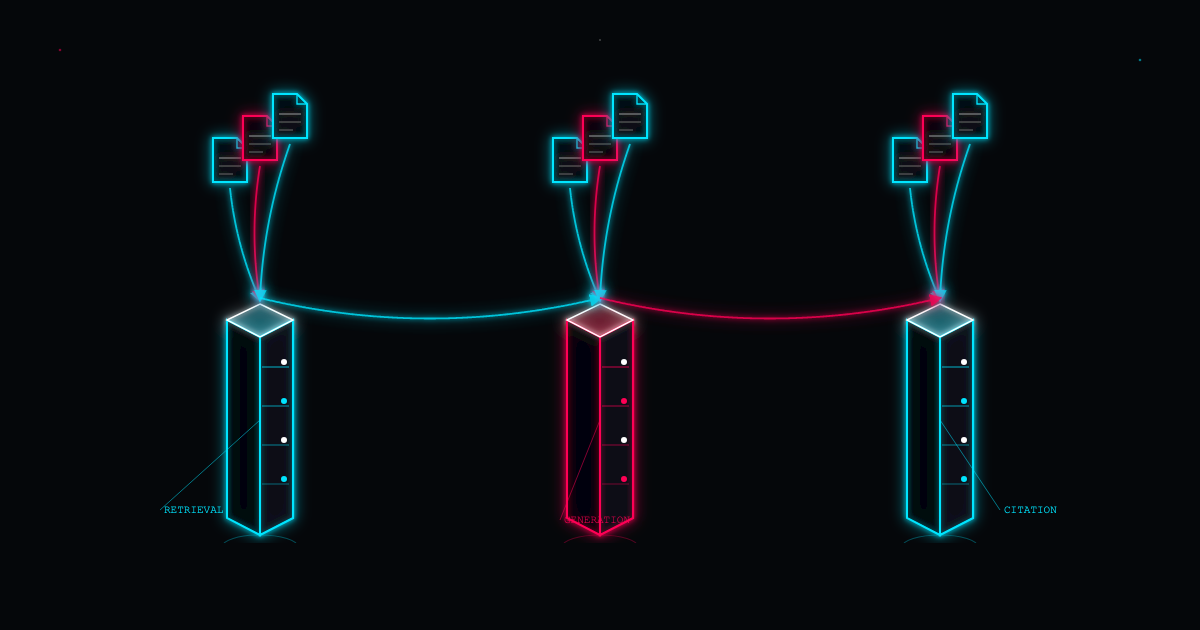
Tribal Knowledge wird strukturiert: Statt 'Senior Person kennt das' → dokumentiert, versioniert, auffindbar. ibl.ai's Knowledge Management Agent crawlt SharePoint/Confluence/ServiceNow/Wikis autonom, erkennt Knowledge Gaps, flaggt At-Risk Content bei Mitarbeiter-Austritt. IBM watsonx ContentIQ bringt No-Code RAG-Pipeline, 2-Tage-Deployment, citation-backed Answers, RBAC inherited von Source-Systemen. Beide lösen dasselbe Problem: 5M+ USD Lost per 1.000 Workers/Jahr (IDC) durch Information Recreation. Der Unterschied zu klassischem Enterprise-Search: Proaktive Gap-Detection, Multi-Step-Reasoning über Dokumente, automatische Documentation-Task-Generation.
ibl.ai Knowledge Management Agent: Proaktiv statt Reaktiv
Der ibl.ai-Agent wartet nicht auf Queries, er agiert autonom:
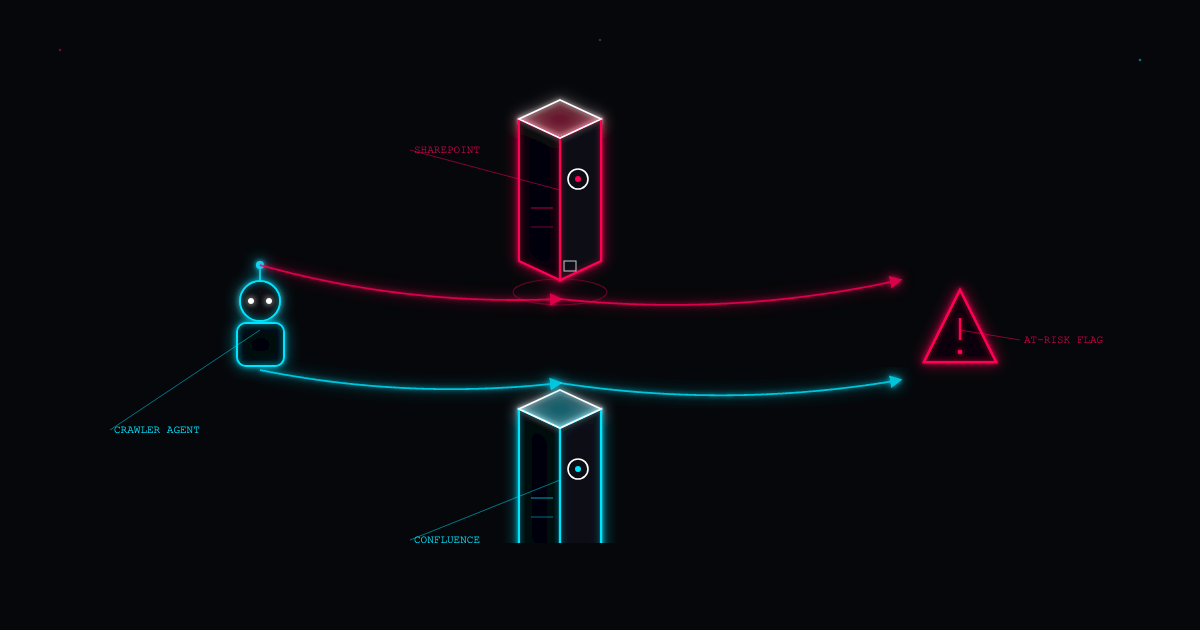
- Continuous Crawling: Scheduled Crawl-Cycles (configurable Cadence, z.B. alle 6h) über SharePoint, Confluence, ServiceNow, Wikis, Email-Archives, File-Shares. Detects new/modified Content, re-indexed automatically.
- Knowledge Gap Detection: Vergleicht Query-Logs gegen indexed Content. Recurring unanswered Questions → creates Documentation-Tasks assigned to Subject-Matter-Experts via ServiceNow/Jira.
- At-Risk Knowledge Flagging: Integration mit Workday/Oracle HCM: Detects upcoming Departures, initiates structured Knowledge-Extraction-Workflows VOR Exit-Gespräch.
- Auto-Documentation: Synthesizes Answers from multiple Sources, cited. Bei Contradictions: Flags für Review, routes zu Document-Owners.
- Dependency Tracking: Monitored Policy-Documents für Changes, identifies downstream Content (referencing Policies), flags/updates dependent Docs automatically.
Der Agent ist komplett air-gappable: Full Source-Code delivery, runs on-premise, zero Data leaves Infrastructure. Suitable for Government, Defense, regulated Industries.
IBM watsonx ContentIQ: 2-Tage-Deployment
IBM's Pitch: "Turn SOPs, manuals, websites into trusted answers. Deploy in days, without data-science team."
Die No-Code-RAG-Pipeline automatisiert: Document-Chunking, Vector-Embedding-Generation, Metadata-Extraction. User connecten SharePoint/OneDrive/Box/Drive/Websites, Agent crawlt/bereinigt/ingestiert.
Citations on every Answer: Link back to Source-Doc, User verifiziert. Answers strictly grounded in User-Content, no blended public Web-Data.
RBAC inherited from Source-Systems: Antworten respektieren existing Permissions. Zwei User fragen dasselbe, bekommen unterschiedliche Antworten (je nach Access-Rights). Das ist kritisch: Ein Knowledge-Agent der sensitive Docs leaked ist ein Data-Breach.
IDC-Studie: 1.000 Knowledge-Workers verschwenden 5M+ USD/Jahr durch Zeit, die sie mit Suchen verbringen oder Information neu aufbauen, die bereits existiert (aber nicht gefunden wird).
Die Root-Causes:
- Scattered Content: Answer exists in SOP on SharePoint, Runbook in Confluence, Thread in Slack, closed Ticket from 2023 – aber kein Tool findet es cross-platform.
- Keyword-Search Failure: "What's the escalation-path for failed settlement?" matcht nicht "Settlement-Issue-Resolution-Procedure" (semantically äquivalent, lexically different).
- Access-Silos: Knowledge exists, aber User hat keine Permission – statt "Access denied" zu sagen, rebuilden sie.
Knowledge-Management-Agents lösen alle drei: Cross-Platform-Indexing, Semantic-Search, Permission-Aware-Retrieval.
Multi-Step-Reasoning vs. Simple-Lookup
Simple Enterprise-Search: User-Query → Keyword-Match → List of Docs.
Knowledge-Agent Reasoning:
- Query-Decomposition: "What's the escalation-path?" → three Sub-Queries (Policy, Workflow, real Cases)
- Multi-Source-Retrieval: Search SOP (Policy), Confluence (Workflow), ServiceNow (Cases) parallel
- Conflict-Resolution: Policy says "escalate to Manager", Case shows "escalate to VP" → Flags Contradiction, asks for Authoritative-Source
- Synthesis: Combines Policy + Workflow + Case-Example → comprehensive cited Answer
Das ist nicht mehr "Search", sondern "Research".
CODISH-Kunden-Szenario: Fluktuation mit Knowledge-Loss
Problem: Senior-Developer verlässt Firma, nimmt Wissen über Legacy-System mit. Documentation existiert, aber veraltet, lückenhaft, scattered.
Knowledge-Agent-Workflow:
- Workday-Integration detects Departure (Notice-Period startet)
- Agent analyzed Developer's Email/Slack/Commits → identifies Key-Knowledge-Areas (Legacy-System-X, Deployment-Process-Y)
- Erstellt Knowledge-Extraction-Tasks: "Document Legacy-System-X Architecture", "Update Deployment-Runbook für Process-Y"
- Assigned zu Developer + Backup-Person (pair Knowledge-Transfer)
- Nach Exit: Agent scanned Documentation-Coverage, flags Gaps, triggers Follow-up with Team
Result: Knowledge bleibt, auch wenn Person geht.
Knowledge Management Agents retten institutionelles Wissen vor dem Exodus: ibl.ai (proaktiv crawlend, Gap-Detection, At-Risk-Flagging, air-gappable) und IBM ContentIQ (No-Code RAG, 2-Tage-Deploy, RBAC). Lösen 5M+ USD Lost/1.000 Workers durch Information Recreation. Multi-Step-Reasoning statt Simple-Lookup, Cross-Platform-Indexing statt Silos. CODISH-Szenario: Senior-Developer-Exit → Agent erkennt Knowledge-Gaps VOR Departure, strukturiert Extraction. Tribal Knowledge wird strukturiert – dokumentiert, versioniert, auffindbar.